死活監視ってPingを打って返り値が返ってきたらOKですよね?
確かにPing監視は死活監視の基本ですよね。
しかし、サーバの中で動いているサービスが停止していた場合はどうでしょうか?
Pingが通る=サーバが正常
とは限らないのです。
私自身も過去に、Ping監視では異常を検知できなかった障害に遭遇したことがあります。
そこで今回は、
「Pingが通るのにサーバが正常とは限らない理由」
について、体験談をを交えながら紹介したいと思います。
- この記事を読むとわかること
そもそもPingとは?
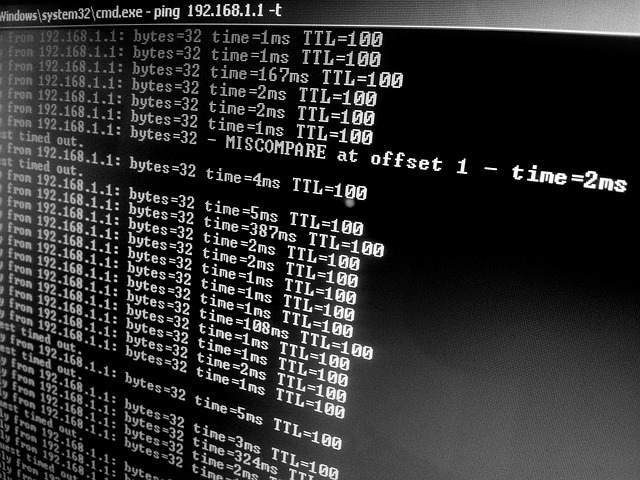
知っている方も多いと思いますが、Pingは対象サーバへ通信を行い、応答があるかを確認するコマンドです。
障害調査をする時、とりあえず最初にPingを打つ人も多いのではないでしょうか。
私もまず最初に実施します。
例えば以下のようなコマンドです。
ping 192.168.xxx.xxx
応答が返ってくれば、
ことが分かります。
ここで新人の頃の私は、
「Pingが返ってきているなら大丈夫そうだな」
と思っていました。
でも実際はそうとも限りません。
Pingは返ってくるのに、利用者からは
「システムが使えません」
と問い合わせが来ることがあります。
なぜなら、Pingで確認できるのはサーバから応答があることだけだからです。
サーバの中で動いているWebサービスや業務アプリケーションが正常かどうかまでは分かりません。
PingはNWが繋がっていることが確認出来るということが確認出来るコマンドだて覚えると良いと思います。
Pingが通ればサーバは正常なの?
結論から言うと、正常とは限りません。
例えば、
といった状況でも、OS自体が応答できていればPingは返ってくることがあります。
そのため、
Ping成功 = サーバ正常
ではなく、
Ping成功 = サーバから応答が返ってきている
程度に考えておくと良いでしょう。
私も新人の頃は、
「Pingが返ってきているから大丈夫そうだな」
と思っていました。
しかし実際の障害対応では、Pingは正常なのに利用者から
「システムが使えません」
という問い合わせが来ることがあります。
逆に言えば、Pingが通っている時点でネットワーク経路には大きな問題がない可能性が高いとも考えられます。
そのため障害対応では、
- Pingが通る
- ネットワーク以外を疑う
- サービスやアプリケーションを確認する
という切り分けができます。
つまり、Pingは万能ではありませんが、障害対応において非常に重要なヒントになるということです。
実際にあった障害事例
過去に、サーバの死活監視としてPing監視を実施していたことがありました。
ある日、
「システムが利用できない」
という問い合わせが発生しました。
まず監視システムを確認しましたが、死活監視のアラートメールは届いていませんでした。
そのため最初は、
「利用者側の問題かな?」
と思っていました。
つまり、
| 項目 | 状態 |
|---|---|
| Ping監視 | 正常 |
| サーバ応答 | 正常 |
| 業務システム | 停止 |
| 利用者 | 利用不可 |
という状況だったのです。
しかし実際にサーバへ接続しようとすると、なぜか接続できません。
そこで、
「アプリケーションよりも前段で何か問題が起きているのでは?」
と考え、サーバを確認することにしました。
サーバを再起動してハードウェアの状態を確認したところ、RAIDコントローラ※1の故障が判明しました。
Ping監視では異常を検知できていませんでしたが、実際にはサーバは正常なサービスを提供できない状態だったのです。
この時に、
「Pingが通る=サーバ正常」ではない
ということを身をもって経験しました。
※1RAIDコントラーラとは?
RAIDコントローラとは、サーバ内のディスクを管理するための機能です。
この機能が故障すると、ディスクが正常でもサーバが正常に動作できなくなることがあります。
なぜPingは通っていたのか
PingはOSレベルで応答します。
そのため、
・Webサービス
・業務アプリケーション
・データベース
などが停止していても、OSが応答できる状態であればPingは返ってくることがあります。
つまり、
「利用者がシステムを利用できるか」
と
「Pingが返ってくるか」
は別の話なのです。
新人の頃は、
「サーバへ接続できない = サーバが完全に停止している」
と思いがちです。
しかし実際には、OS自体は応答していても、サービスが停止していたり、ハードウェア障害によって正常に処理できなくなっているケースもあります。
私が経験した障害でも、Ping監視では異常を検知できていませんでしたが、RAIDコントローラの故障によってシステムは正常に利用できない状態になっていました。
このように、Pingは障害切り分けの第一歩として有効ですが、それだけでサーバの正常性を判断することはできません。
Ping監視だけでは不足する理由
そのため実際の運用では、Ping監視だけでなく複数の監視を組み合わせて利用します。
| 監視項目 | 確認内容 |
|---|---|
| Ping監視 | サーバへ到達できるか |
| サービス監視 | IISやApacheが起動しているか |
| プロセス監視 | 必要なプロセスが動作しているか |
| URL監視 | 実際にWeb画面へアクセスできるか |
| ログ監視 | エラーが発生していないか |
このように複数の観点で監視することで、利用者影響のある障害を検知しやすくなります。
まとめ
今回は「Pingが通るのにサーバが正常とは限らない理由」について紹介しました。
記事のポイントをまとめると以下の通りです。
| 項目 | 内容 |
|---|---|
| Pingで分かること | サーバへ到達できること、OSから応答があること |
| Pingで分からないこと | サービスや業務アプリケーションが正常に動作しているか |
| 実際の事例 | Ping監視は正常だったが、RAIDコントローラ故障により業務停止が発生 |
| 障害対応時の考え方 | Pingが通る場合はサーバ側のサービスやハードウェアも疑う |
Pingは障害調査の第一歩として非常に重要なコマンドです。
しかし、
「Pingが通る = サーバ正常」
とは限りません。
私自身も今回紹介した障害を経験してからは、Pingだけで判断せず、サービスやハードウェアの状態も確認するようになりました。
今回の記事が、これからインフラエンジニアを目指す方や障害対応を行う方の参考になれば幸いです。


コメント